World Jacobin
Haben die gemäßigten Demokraten die Linken wirklich übertroffen? NEIN.
Im Gegensatz zu dem, was zentristische Experten sagen könnten, ist es keine einfache Aufgabe, zu beurteilen, wie gemäßigte und linksgerichtete Demokraten bei den Zwischenwahlen abgeschnitten haben. Aber wie auch immer man die Daten aufteilt, das lässt sich nicht beweisen
English (original) ·Auto-translated to Deutsch
Die Demokraten haben bei den Zwischenwahlen 2026 gut abgeschnitten. Nach der aktuellen Bilanz haben sie einundvierzig zugelegtHaussitze, achtSitze im Senatund fünfGouverneursämter. Demokratische Kandidaten aller Art hatten Erfolg, was es schwierig machte, einfach mit dem Finger auf diese oder jene Fraktion zu zeigen, die die Wahl vermasselt hatte.
Dies hat zu einer gewissen Frustration unter den Fraktionsparteien geführt, da diese stark von der Vorstellung überzeugt sind, dass ihr Politikstil der Politik anderer Fraktionen bei Wahlen überlegen sei. Sie können nicht auf Gewinner und Verlierer verweisen, die ihre Positionen unterstützen, denn bei dieser Wahl war jeder ein Gewinner. Daher sind sie gezwungen, ihre Argumente durch die Analyse der Gewinnspannen darzulegen, was schwierig zu machen ist und voller Unsicherheiten steckt, selbst wenn es gut gemacht wird.
In diesem Artikel gehe ich verschiedene Ansätze zur Quantifizierung der kandidatenspezifischen Leistung durch, um eine Art Einführung dafür zu geben, wie man darüber nachdenkt und die Flut von Wahlpseudostatistiken erfolgreich bewältigt.
I. Roher Stimmenanteil
Die offensichtlichste, wenn auch naivste Möglichkeit, zwischen Gewinnern zu unterscheiden, besteht darin, ihren reinen Stimmenanteil zu betrachten. Wenn ein demokratischer Kandidat 51 Prozent der in seinem Rennen abgegebenen Stimmen und ein anderer 70 Prozent der in seinem Rennen abgegebenen Stimmen gewonnen hat, dann scheint es auf den ersten Blick so, als könnte man sagen, dass der 70-Prozent-Kandidat besser abgeschnitten hat als der 51-Prozent-Kandidat.
Sicherlich der 70-Prozent-Kandidattatbesser, aber das ist nicht dasselbe wiedurchführenbesser. Wenn Experten über Leistung sprechen, versuchen sie, den Einfluss zu isolieren, den die eigenen Eigenschaften des Kandidaten auf das Wahlergebnis hatten. Bei Rohstimmenanteilen ist dies nicht der Fall, da Rohstimmenanteile auch andere Faktoren widerspiegeln, einschließlich der zugrunde liegenden Tendenzen der Wähler in diesem Bereich. Mit anderen Worten: Es ist möglich, dass der 70-Prozent-Bezirk eher demokratisch ausgerichtet ist und der 51-Prozent-Kandidat in diesem Bezirk auch 70 Prozent erreicht hätte.
II. Erwarteter Stimmenanteil
Um die kandidatenspezifischen Auswirkungen zu isolieren, muss man eine Art Basiswert dafür festlegen, wie die Wahlergebnisse in einer hypothetischen Version des Rennens ausgefallen wären, bei der der Kandidat ein „allgemeiner“ Demokrat gewesen wäre. Es wird dann davon ausgegangen, dass der Unterschied zwischen den tatsächlichen Ergebnissen und diesen „erwarteten“ Ergebnissen die einzigartigen Eigenschaften des Kandidaten widerspiegelt.
Das ist keine leichte Sache und die meisten Bemühungen, die ich im Diskurs sehe, sind lächerlich.
A. Einheitlicher Swing als erwarteter Stimmenanteil
Der gebräuchlichste Ansatz zur Quantifizierung des erwarteten Stimmenanteils besteht darin, zu ermitteln, wie sich der Stimmenanteil landesweit gegenüber der vorherigen Wahl verändert hat, und diese Änderung dann allen Wahlbezirken des Landes einheitlich zuzuordnen. Das ist wasKevin Delucahabe es in der folgenden Grafik getan.
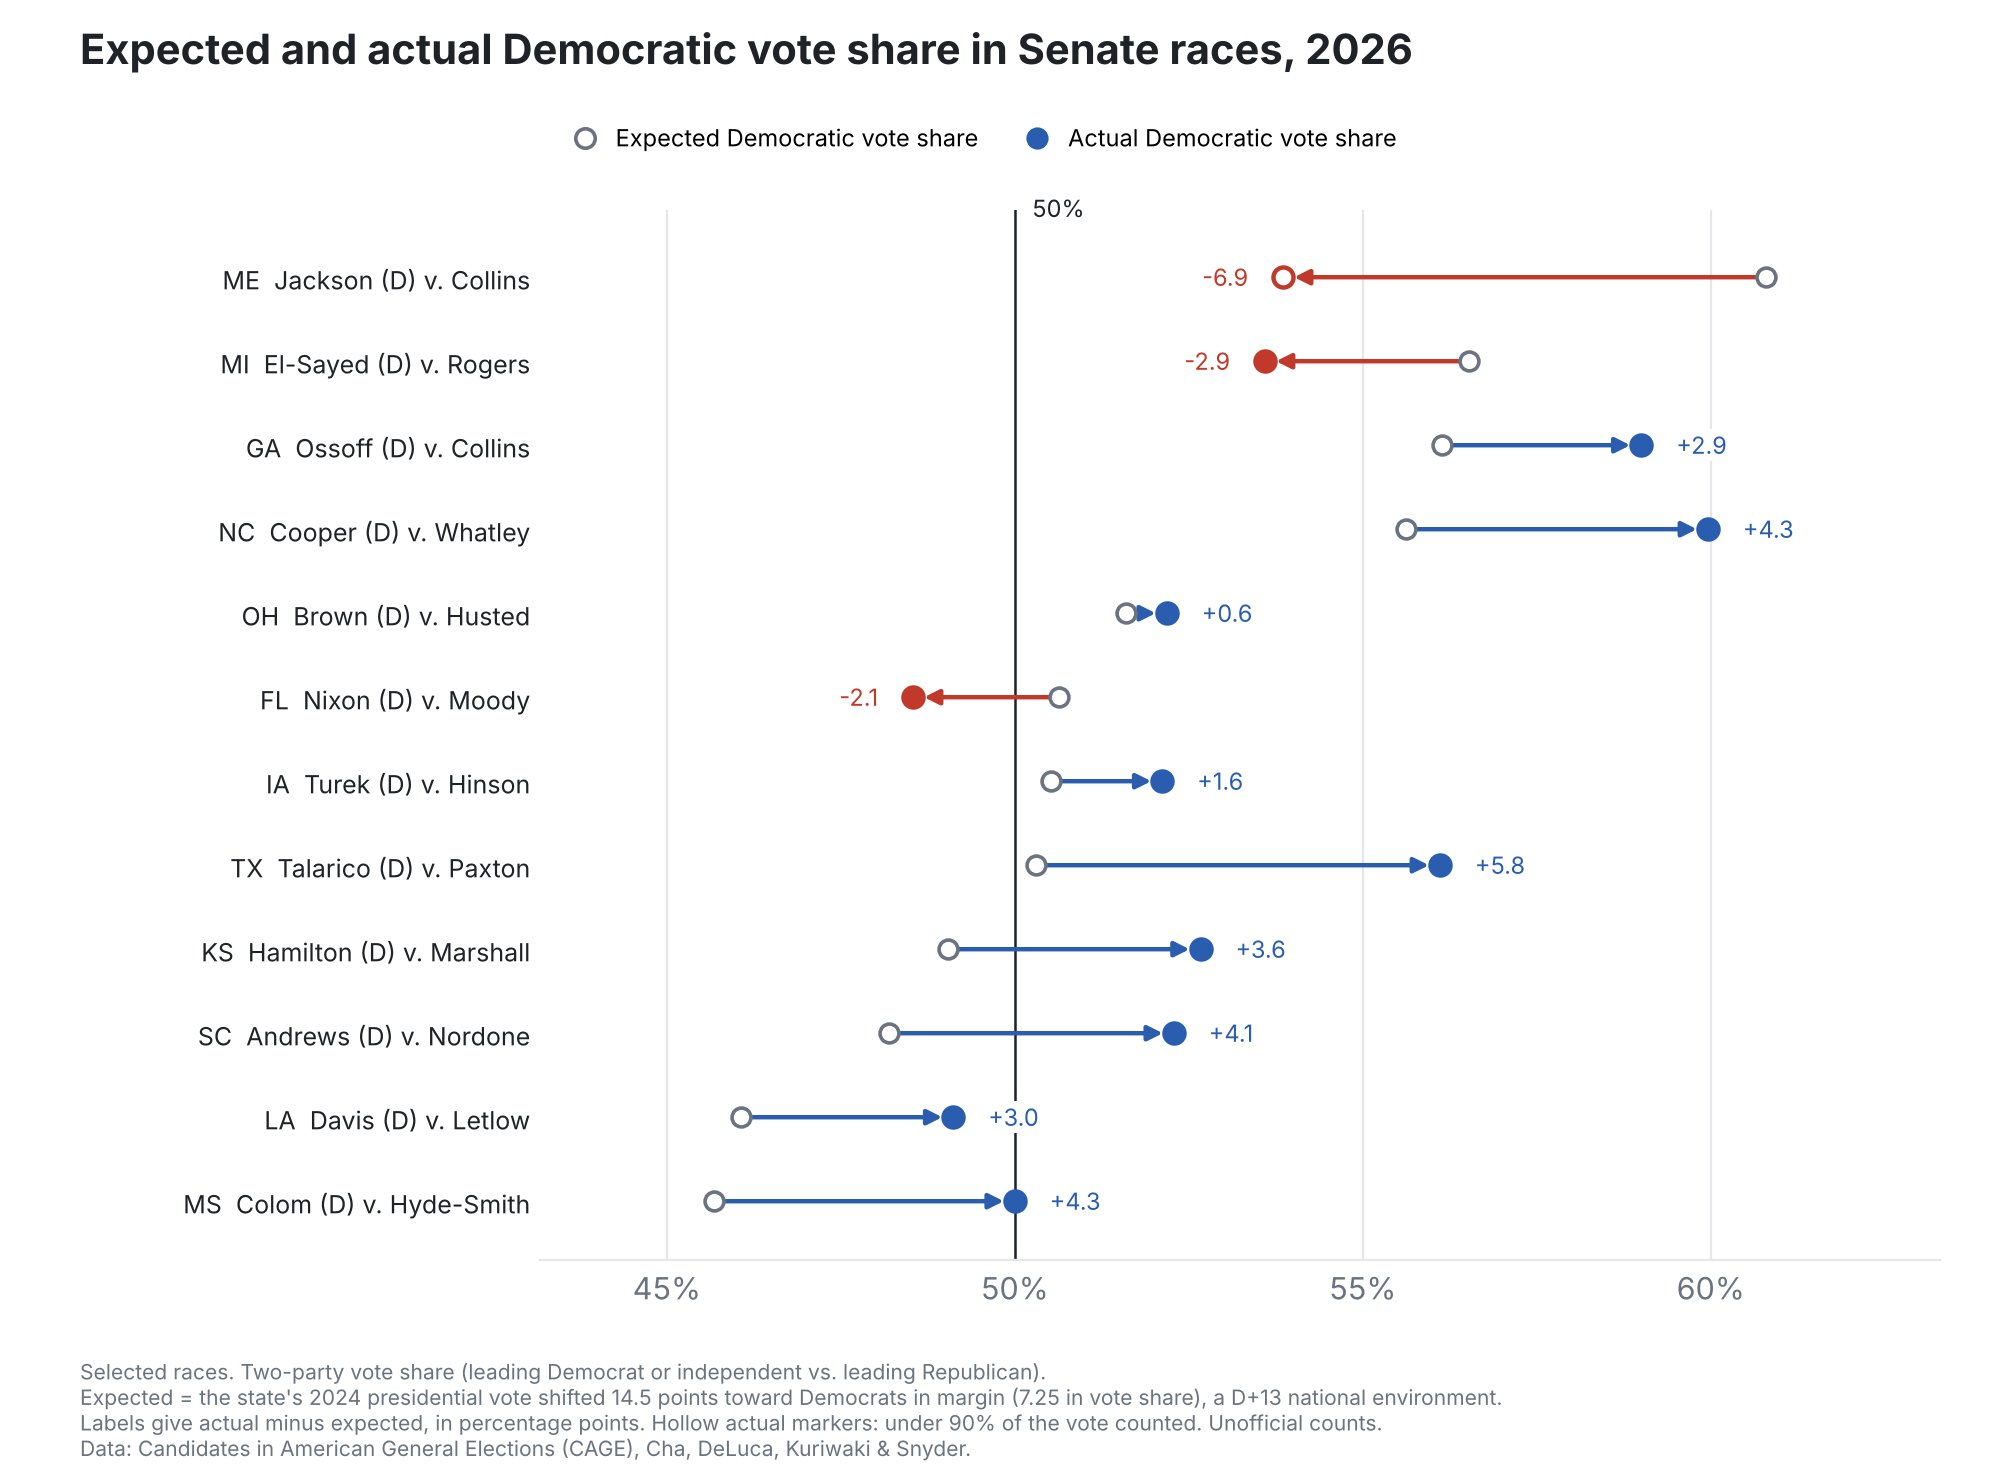
Es mag anspruchsvoll aussehen, aber wie die Bildunterschrift erklärt, hat Deluca lediglich jeden der zwölf Bundesstaaten durchgegangen und Kamala Harris‘ Präsidentschaftsergebnis 2024 in diesem Bundesstaat um 7,5 Punkte erhöht. Dies ist sein gesamtes Modell für den erwarteten Stimmenanteil. Die Differenz zwischen dieser erwarteten Abstimmung und der tatsächlichen Abstimmung wird dann verwendet, um Underperformer und Overperformer zu ermitteln.
Die Einfachheit dieses Modells ist sehr bezaubernd und erklärt zweifellos, warum ich es mehr als jedes andere sehe: Jeder, der addieren und subtrahieren kann, ist in der Lage, das Modell auszuführen. Aber macht es wirklich Sinn anzunehmen, dass jeder von ihnen einen Stimmenanteil von Harris+7,5 erhalten hätte, wenn Sie bei jedem Senatswahlkampf im Land einen generischen Demokraten antreten würden?
Selbst wenn man davon ausgehen würde, dass alle Nicht-Kandidaten-Unterschiede zwischen diesen Staaten und Rassen vollständig durch Harris‘ Präsidentschaftsergebnis 2024 erfasst werden könnten, warum sollten sich gleiche Leistungen von generischen Senatskandidaten als gleiche Veränderungen in Prozentpunkten zeigen? Wäre es nicht sinnvoller, wenn gleiche Leistungen als gleiche Veränderungen in Prozent des nichtdemokratischen Anteils von 2024 angezeigt würden, der in den demokratischen Anteil von 2026 umgewandelt wurde?
Um zu verstehen, was ich meine, stellen Sie sich zwei Bezirke im Repräsentantenhaus vor, einen, in dem Harris im Jahr 2024 80 Prozent der Stimmen erhielt, und einen anderen, in dem Harris im Jahr 2024 20 Prozent der Stimmen erhielt. Wenn Sie in diesen Bezirken generische Demokraten mit gleicher Leistung einsetzen würden, welches Ergebnis würden Sie dann erwarten?
Der Uniform-Swing-Ansatz besagt, dass wir erwarten sollten, dass sie die gleiche Anzahl an Prozentpunkten hinzufügen. So können wir beispielsweise damit rechnen, dass aus dem 80-Prozent-Bezirk ein 90-Prozent-Bezirk und aus dem 20-Prozent-Bezirk ein 30-Prozent-Bezirk wird. In diesem Szenario bewegten sich beide Bezirke gleich stark um 10 Punkte. Aber um 10 Punkte im 80-Prozent-Bezirk zu erreichen, muss man 50 Prozent der nichtdemokratischen Wähler überzeugen. Um 10 Punkte im 20-Prozent-Bezirk zu erreichen, müssen lediglich 12,5 Prozent der nichtdemokratischen Wähler überzeugt werden. Warum sollten wir erwarten, dass ein typischer Demokrat viermal so überzeugend ist wie ein anderer typischer Demokrat? Wie kommt es zu dieser gleichwertigen Leistung?
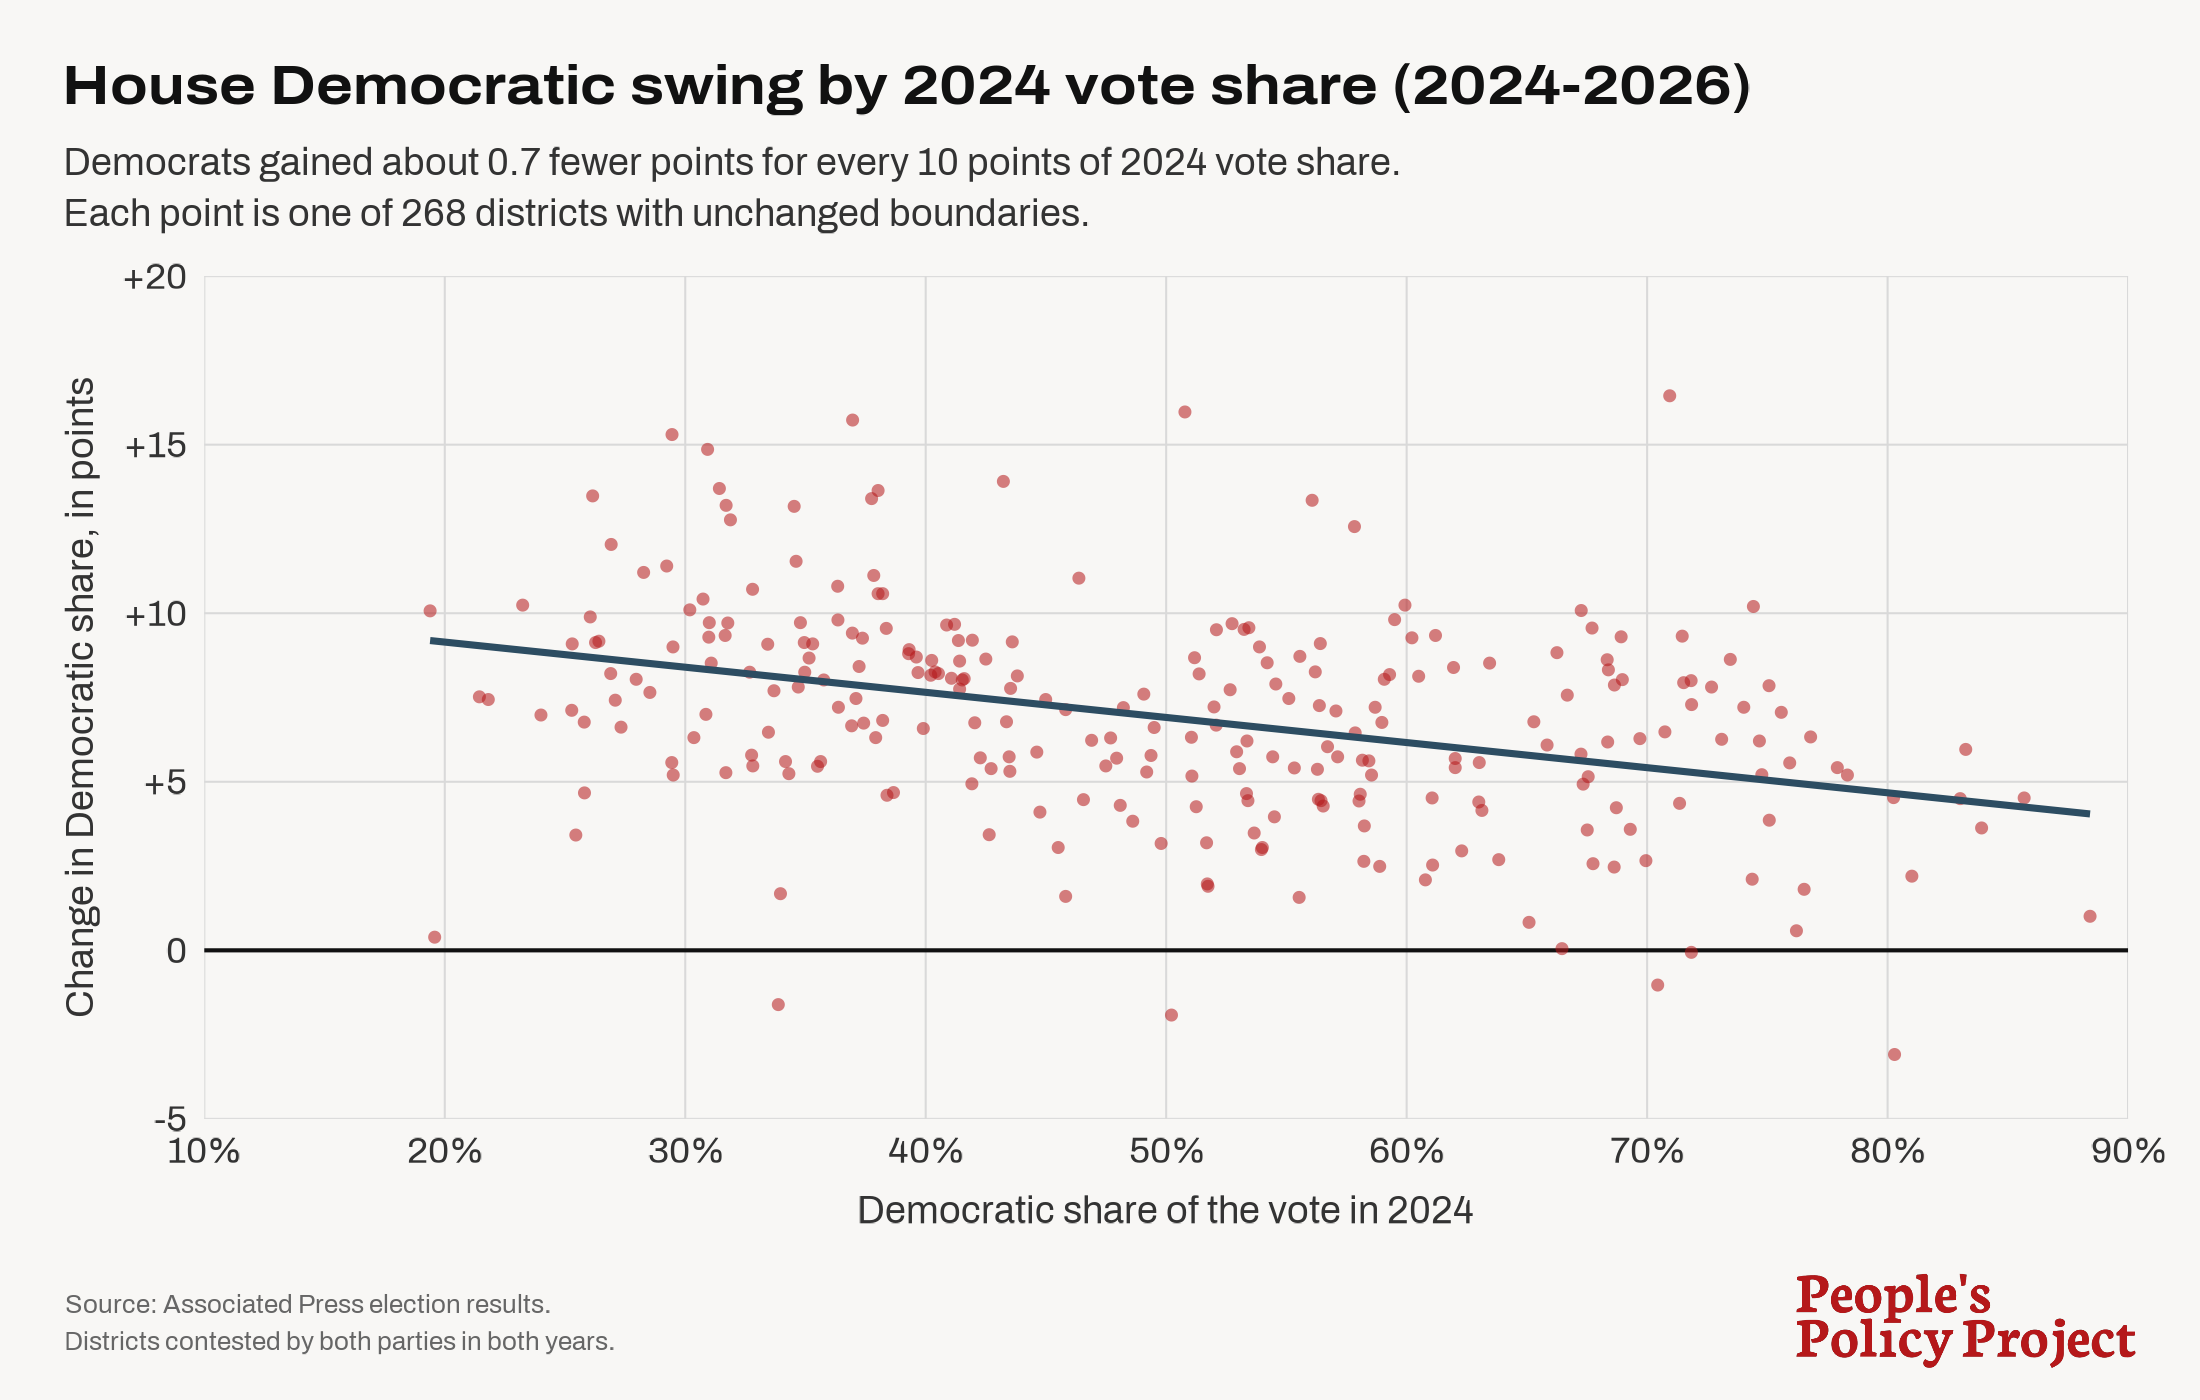
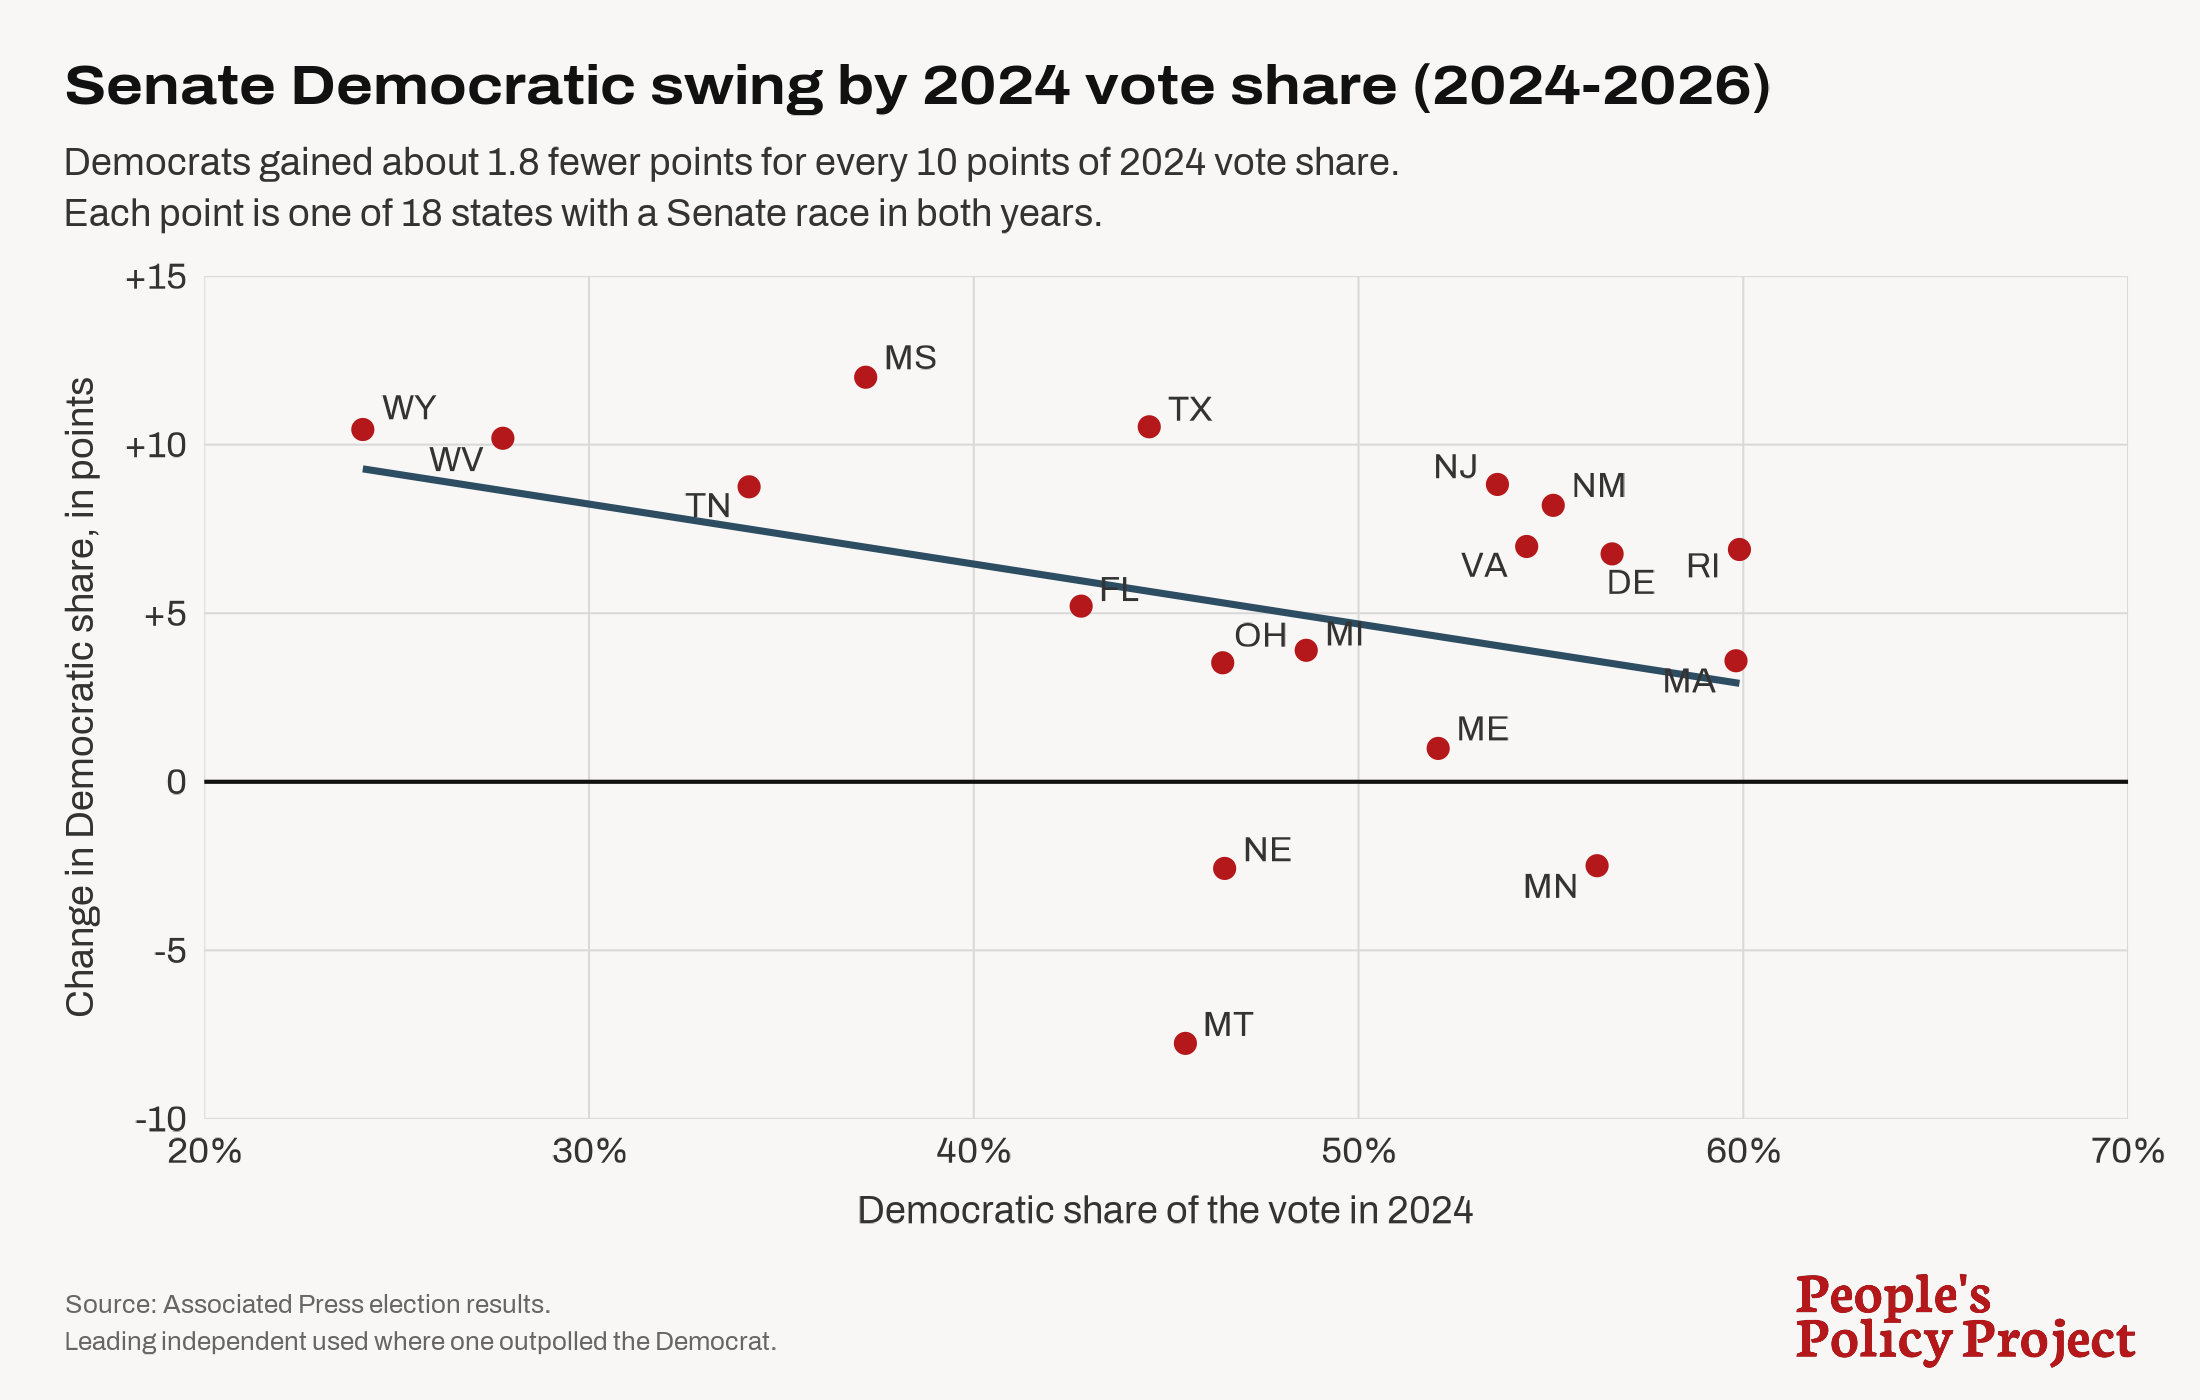
Die Prämisse des Uniform-Swing-Modells, dass gleiche Leistung gleiche Prozentpunkte bedeutet, ist auf den ersten Blick unsinnig. Es ist klar, dass die Anzahl der Punkte, die ein gleichberechtigter Wähler verschieben kann, von Bundesstaat zu Bundesstaat und von Bezirk zu Bezirk unterschiedlich ist, abhängig vom Anteil der Wählerschaft, der überhaupt verschoben werden kann. Einfache lineare Regressionen unter Verwendung der Ergebnisse des Repräsentantenhauses und des Senats liefern empirische Unterstützung für diesen Punkt.
Bei diesem Ansatz zur Modellierung des erwarteten Stimmenanteils gibt es mindestens zwei weitere große Probleme.
Erstens würde ein einheitlicher Stimmenwechsel nur dann Sinn machen, wenn Sie einen generischen Demokraten gegenüber einem generischen Republikaner modellieren würden. Aber in diesen Senatswahlen sind keine generischen Republikaner vertreten. Troy Jackson aus Maine trat mit Susan Collins gegen eine 30-jährige Amtsinhaberin an, während James Talarico aus Texas mit Ken Paxton gegen einen von Skandalen geplagten Nicht-Amtsinhaber antrat. Die Differenz zwischen dem tatsächlichen Stimmenanteil und dem erwarteten Stimmenanteil würde die kombinierten Kandidateneffekte sowohl des demokratischen Kandidaten als auch des republikanischen Kandidaten erfassen.
Wenn Troy Jackson beispielsweise zwei Punkte hinter dem erwarteten Stimmenanteil mit einheitlichem Swing liegt, könnte das daran liegen, dass er negative Kandidateneffekte hat, weil Collins positive Kandidateneffekte hat oder an einer Kombination aus beidem. Wenn Talarico beim erwarteten Stimmenanteil zwischen generischen und generischen Kandidaten zwei Punkte Vorsprung hat, könnte das daran liegen, dass er positive Kandidateneffekte hat oder dass Paxton negative Kandidateneffekte hat. Konstruktionsbedingt geht der Uniform-Swing-Ansatz davon aus, dass die relative Über- oder Unterleistung der republikanischen Kandidaten einheitlich Null ist.
Zweitens haben verschiedene Bezirke unterschiedliche demografische Zusammensetzungen, die selbst bei gleichwertigen Demokraten zu unterschiedlichen Schwankungen führen sollten. Hier sehen Sie zum Beispiel, wie viel Prozent jeder ethnischen Gruppe in den Jahren 2024 und 2026 landesweit für die Demokraten gestimmt haben.
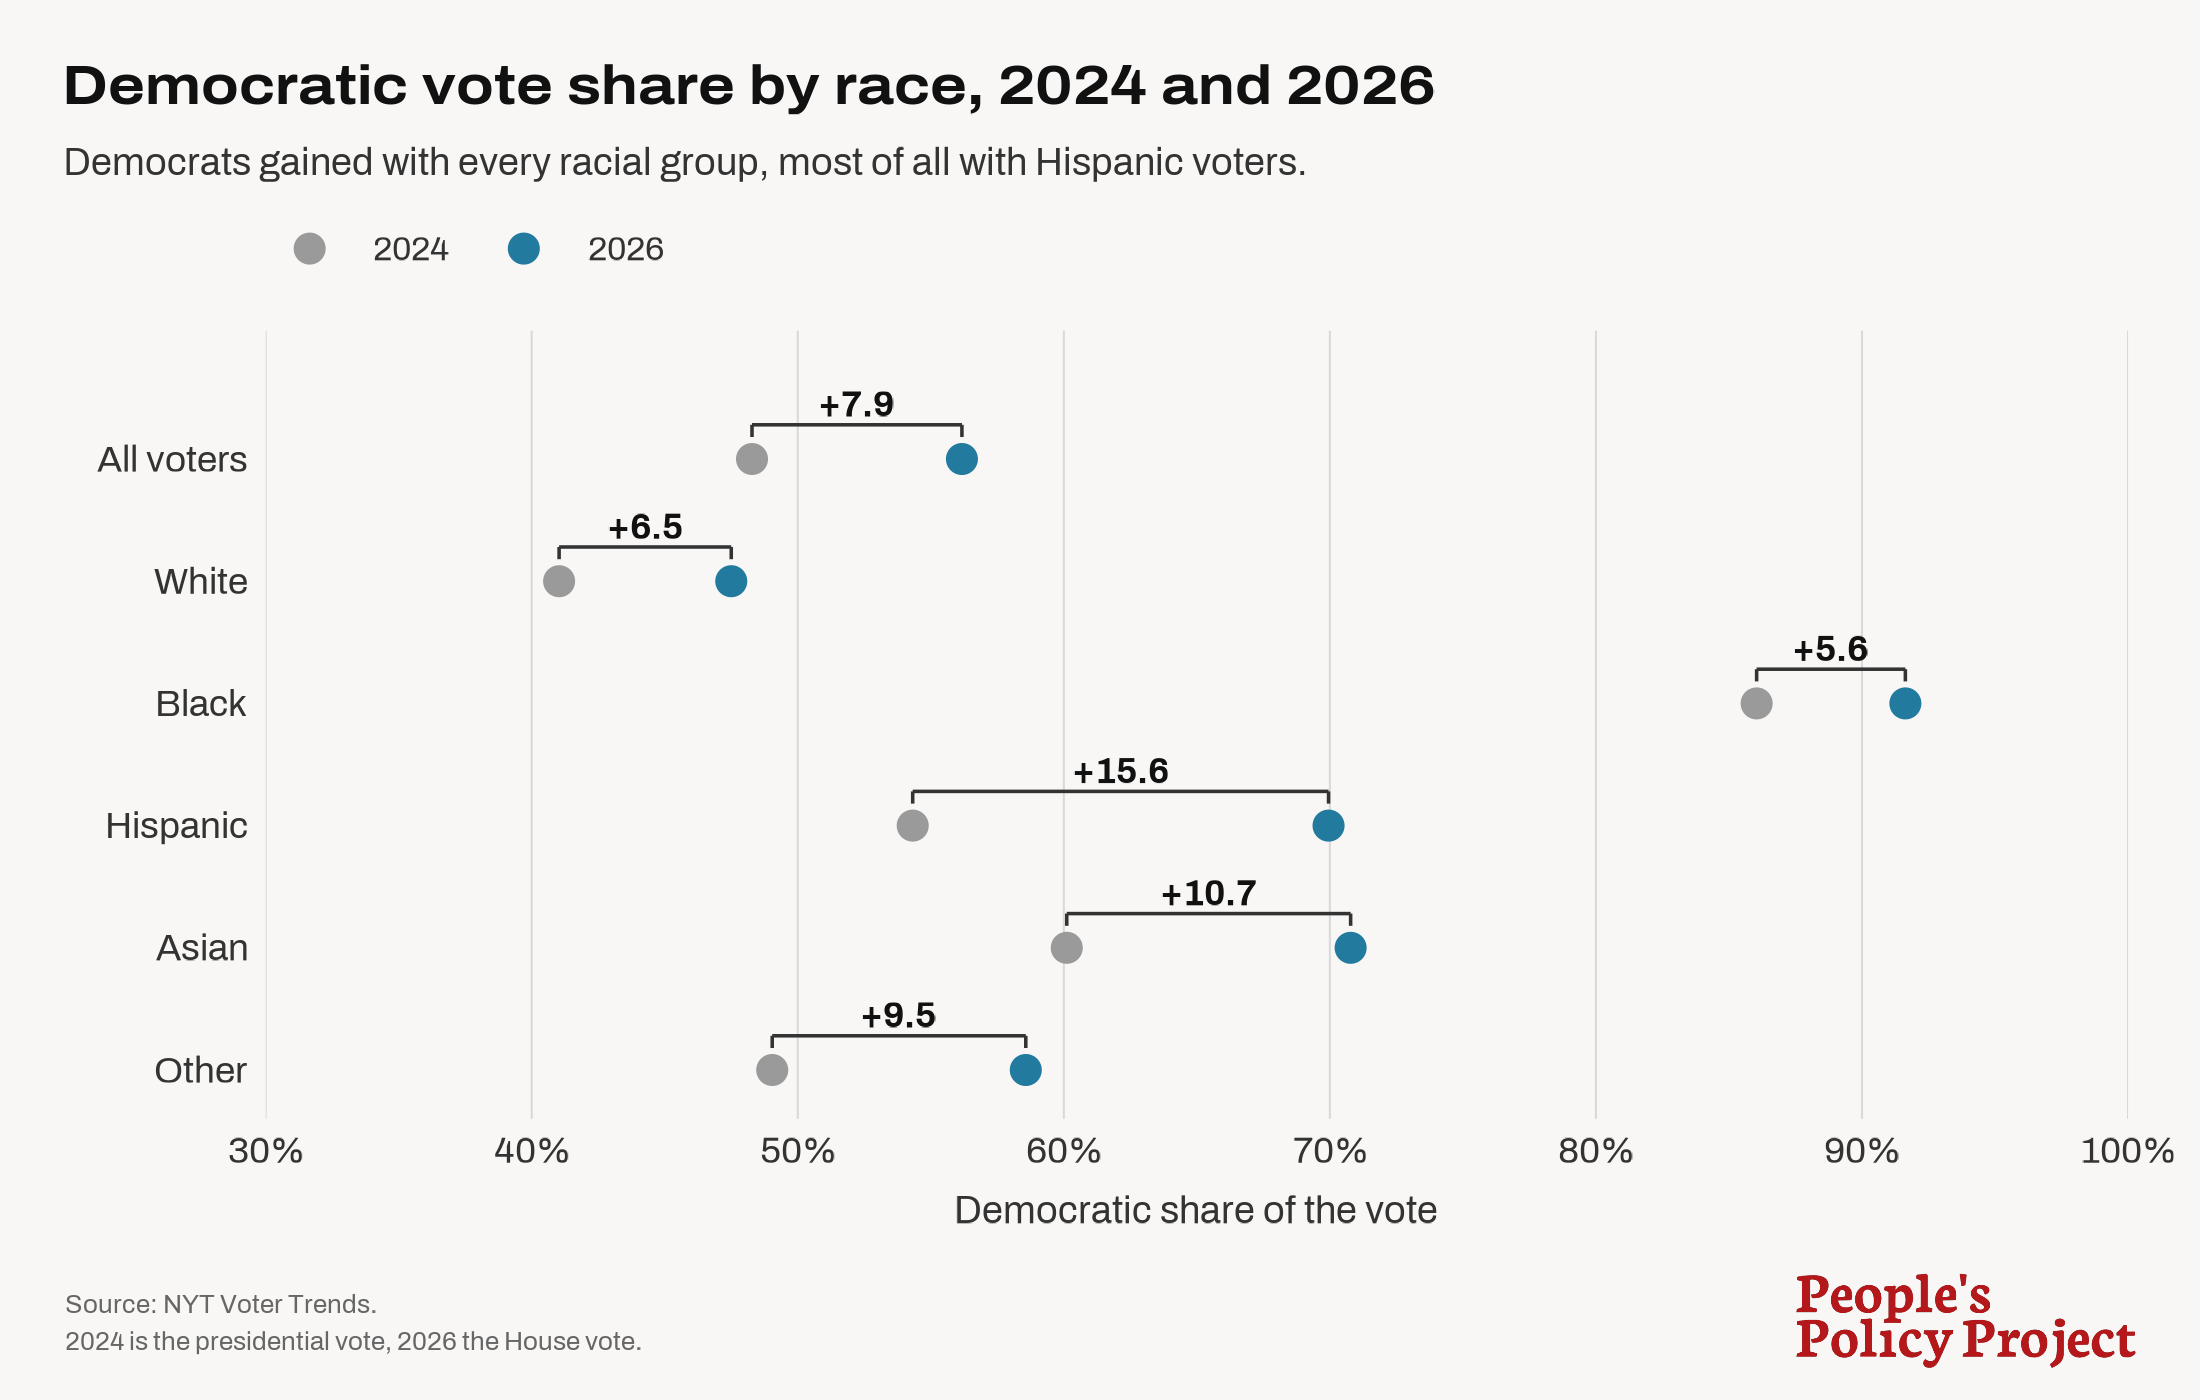
Wie wir sehen können, variiert der Stimmenwechsel je nach Rasse. Angesichts dieser Variation könnten generische Demokraten mit gleicher Leistung in jedem Wahlbezirk nur dann gleichmäßige Stimmenschwankungen erzeugen, wenn jeder Wahlbezirk die gleiche rassische Bevölkerungsstruktur hätte. Das tun sie nicht.
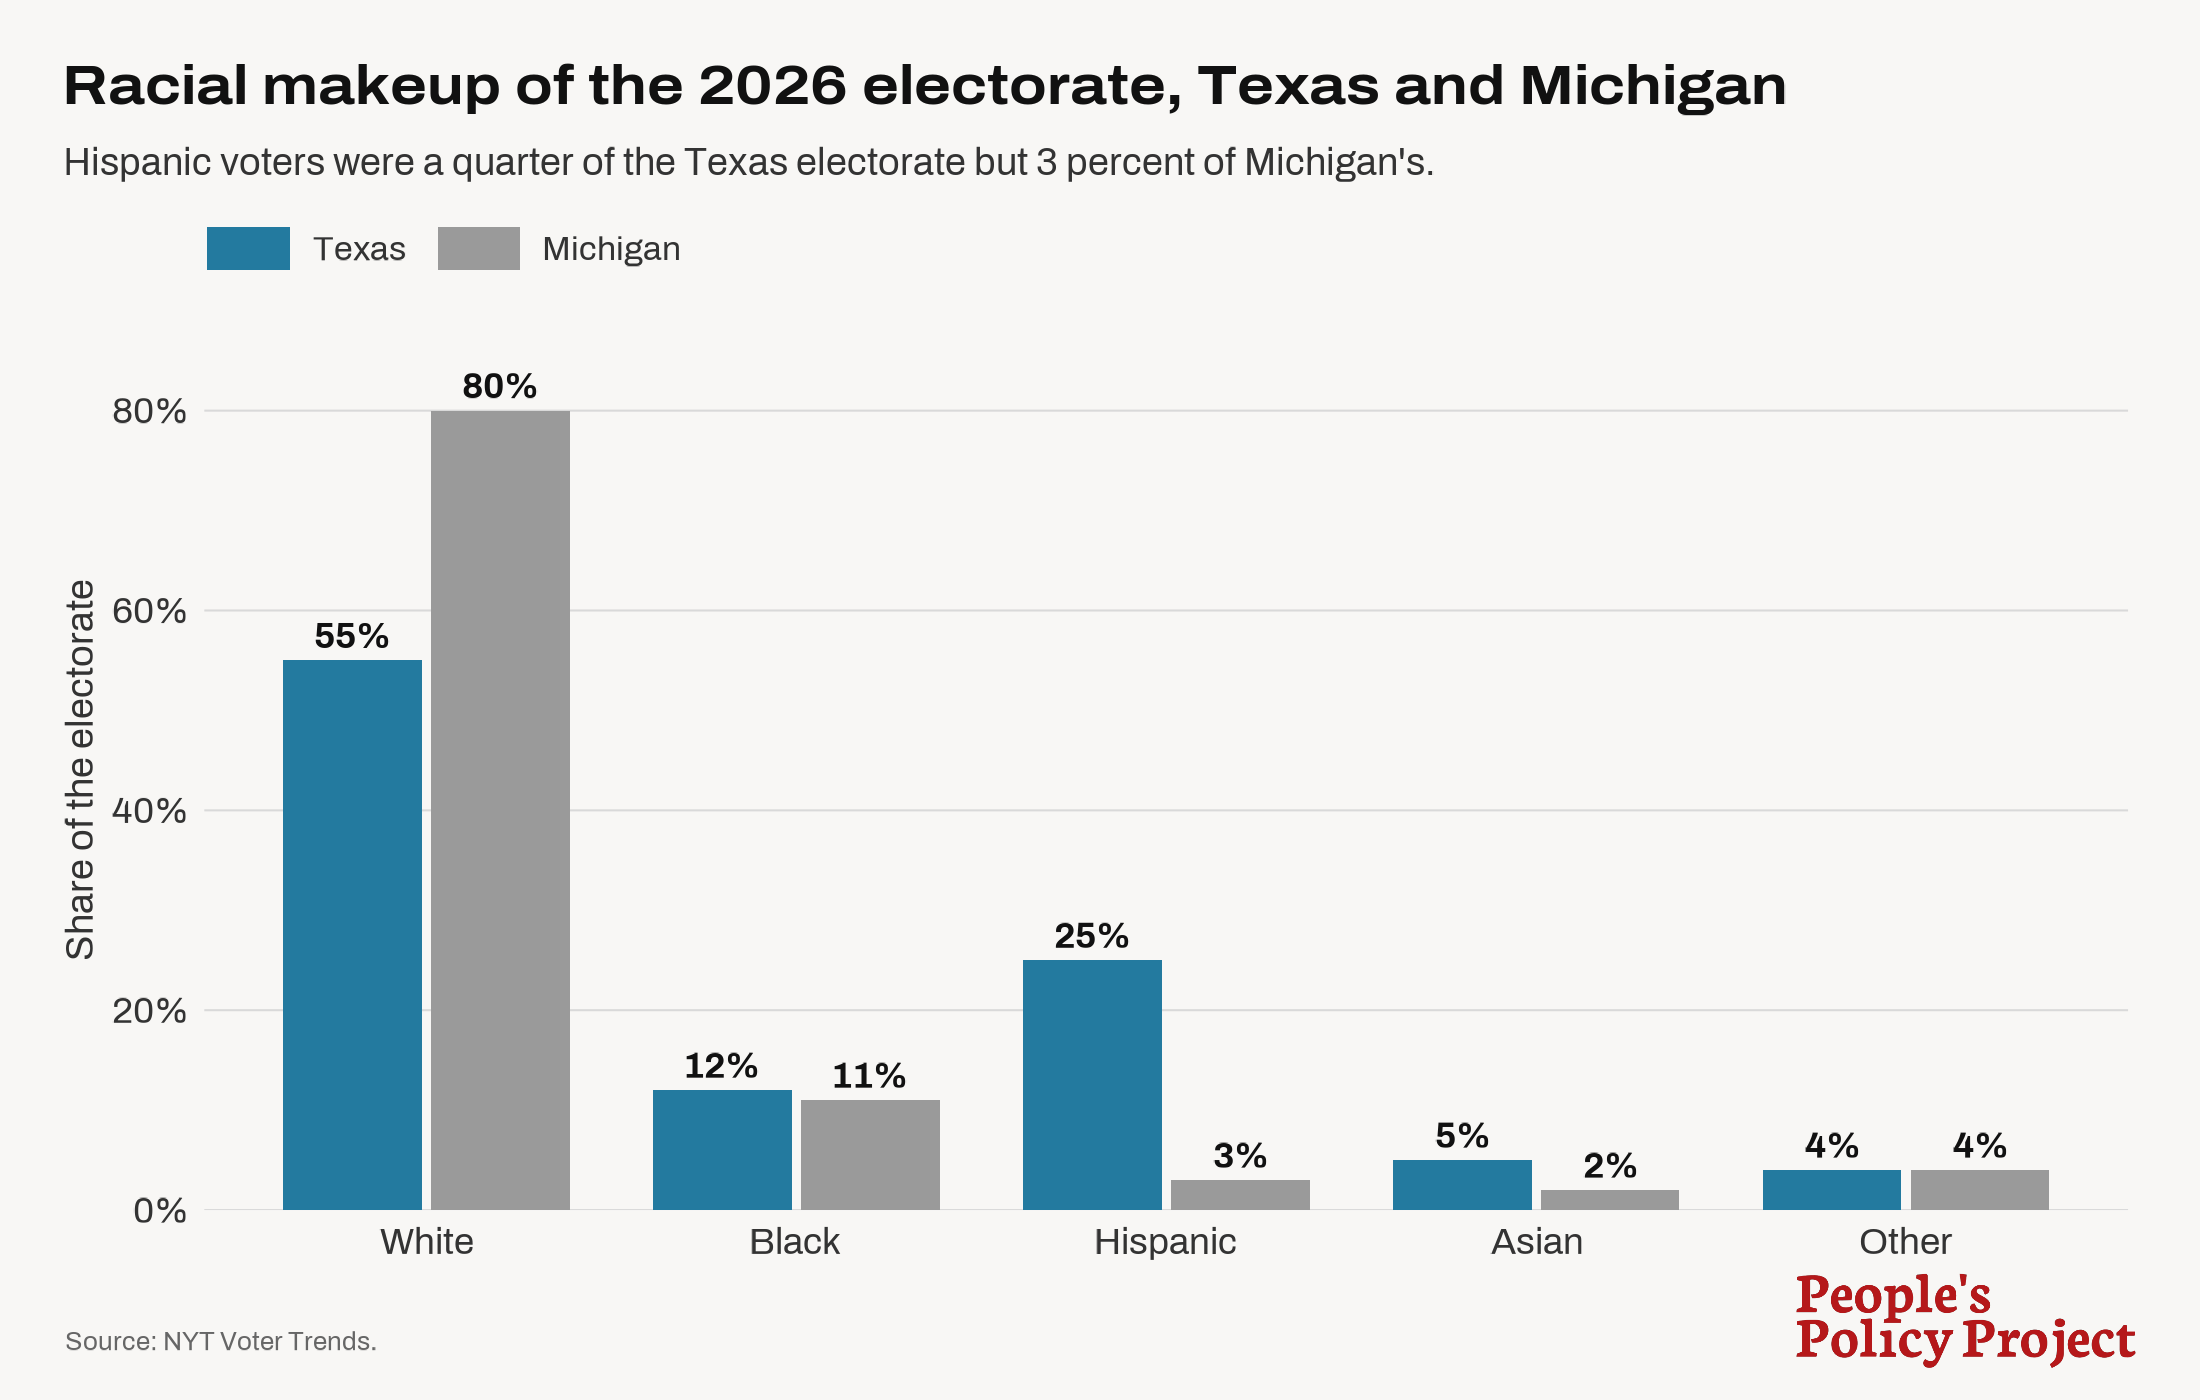
Rasse ist das offensichtlichste Beispiel, aber auch andere demografische Variablen wie Einkommen und Bildung variieren je nach Bezirk und führen auch zu unterschiedlichen Stimmenausschlägen, unabhängig von allem, was mit Kandidateneffekten zu tun hat.
B. Überlappende Wahlen als erwarteter Stimmenanteil
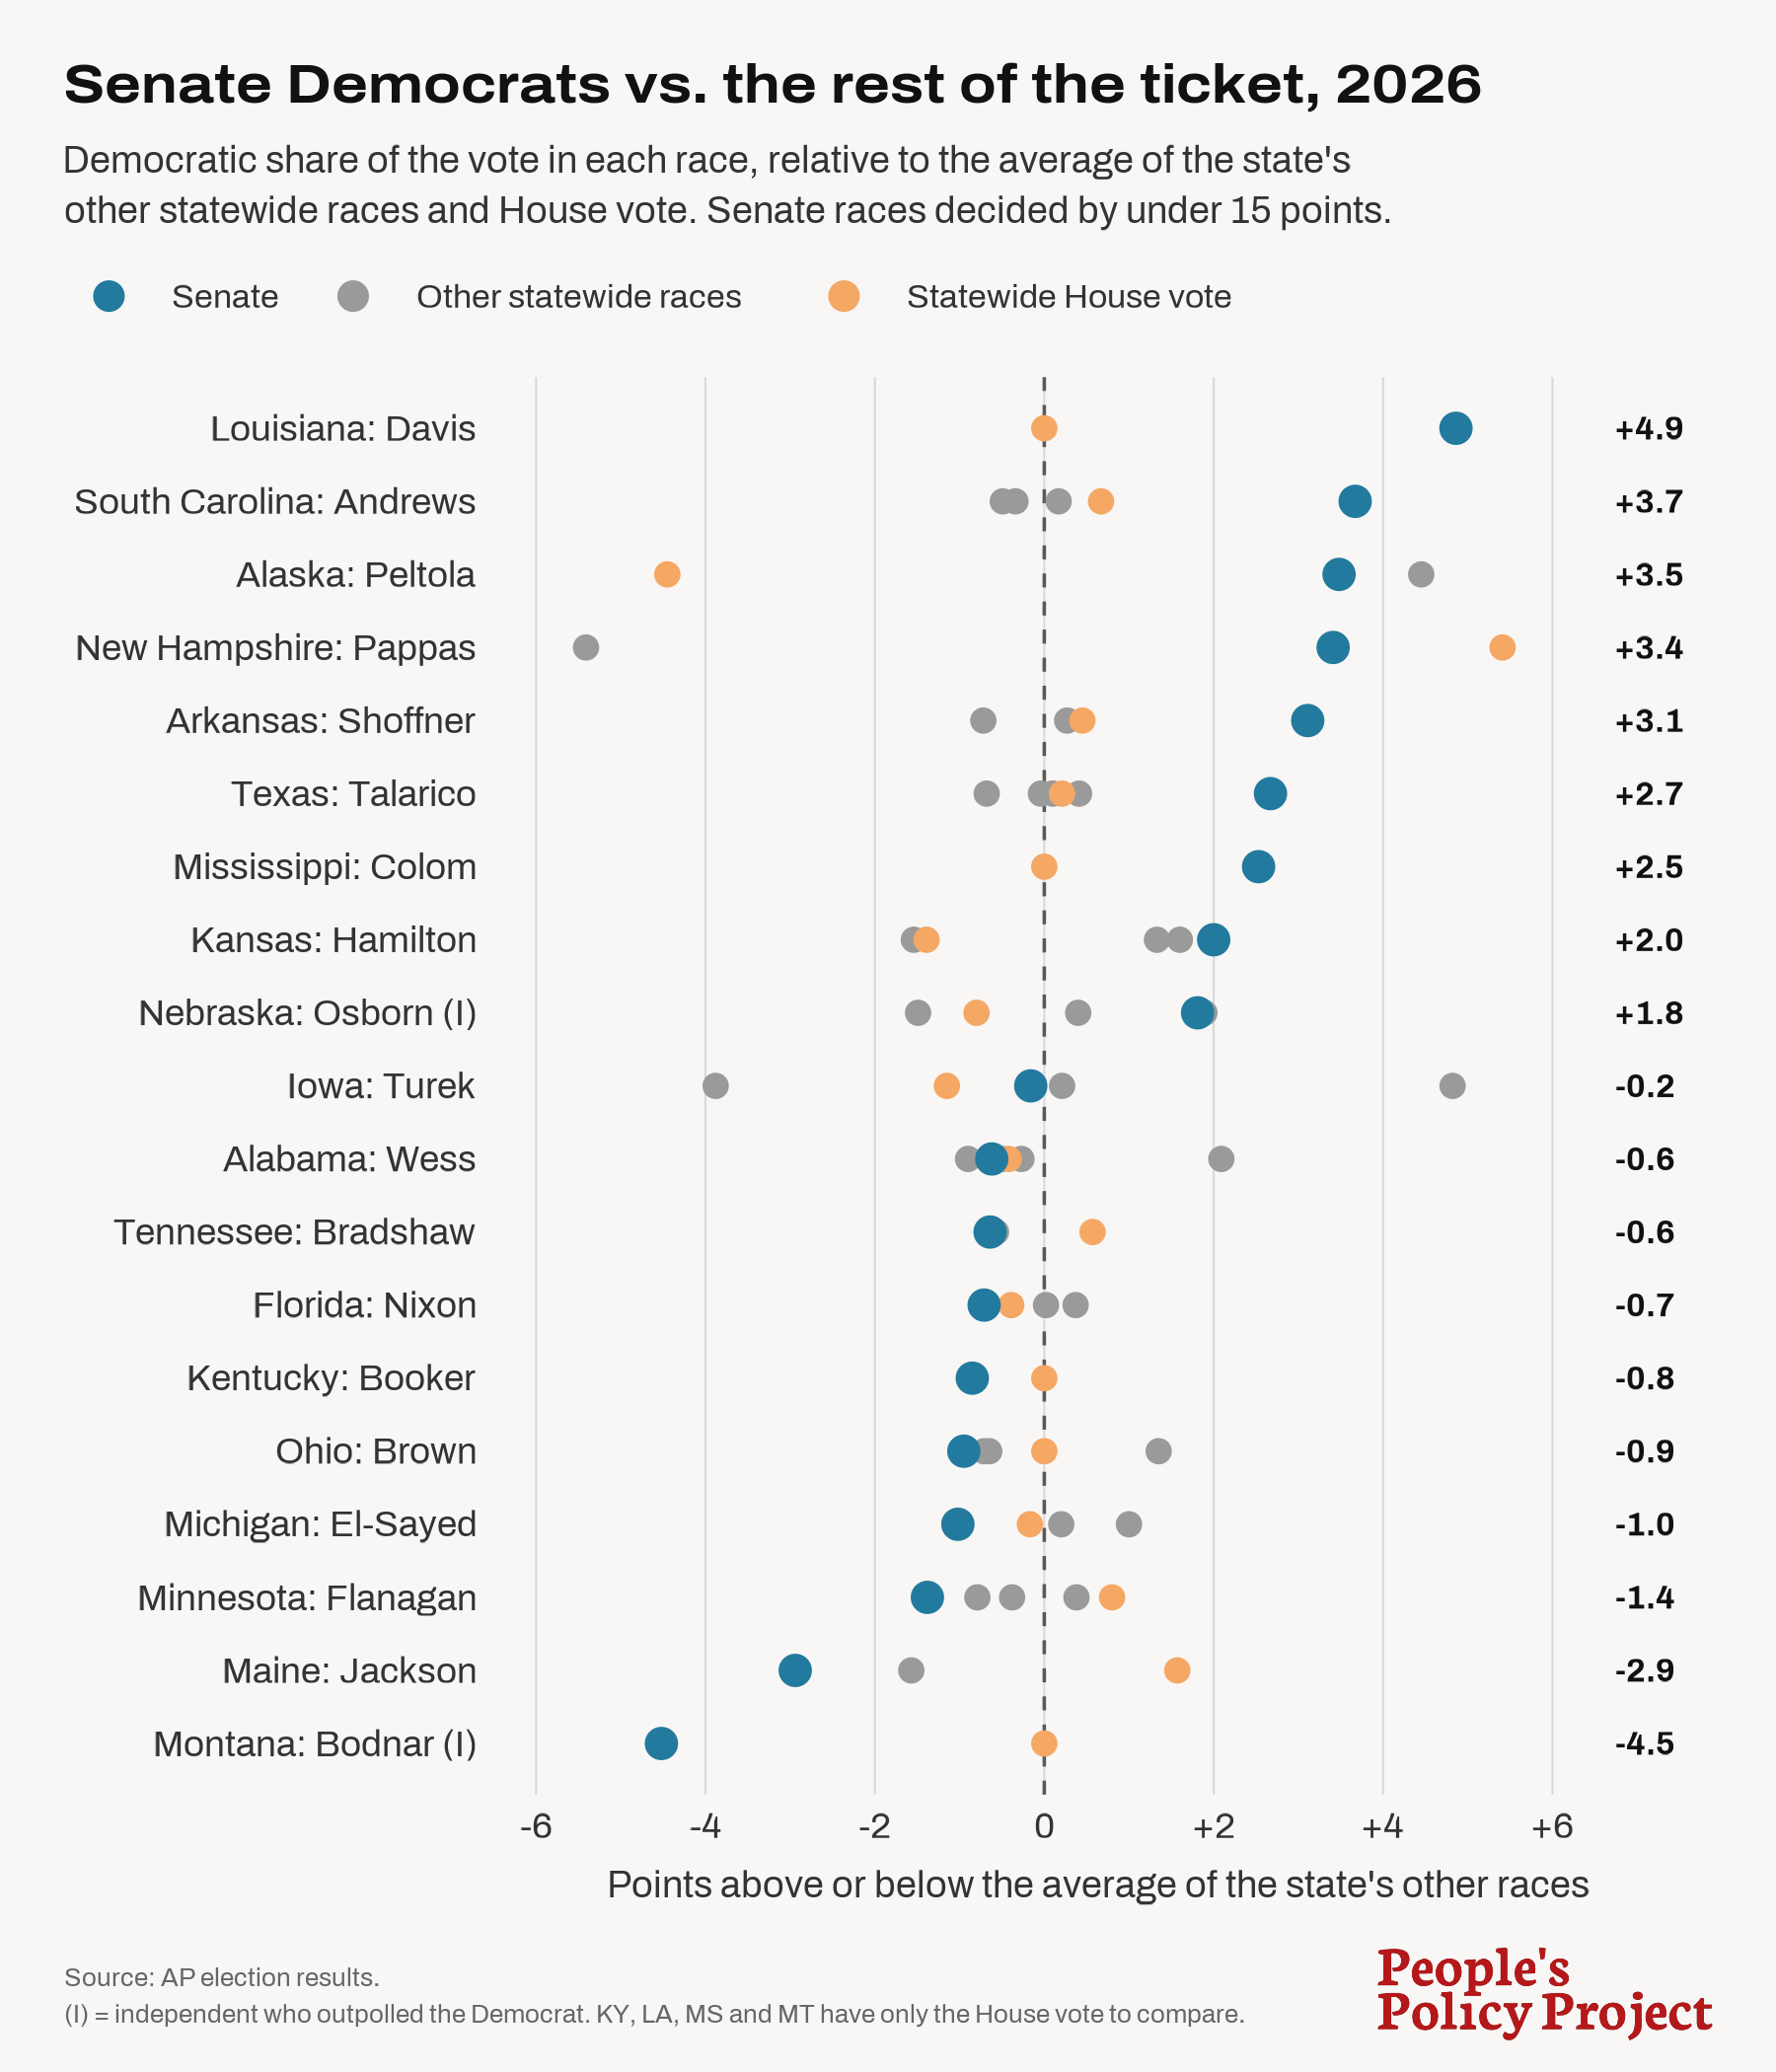
Der zweithäufigste Ansatz zur Quantifizierung des erwarteten Stimmenanteils besteht darin, den Stimmenanteil eines bestimmten demokratischen Kandidaten mit dem Stimmenanteil anderer demokratischer Kandidaten zu vergleichen, die für andere Positionen innerhalb desselben Wahlbereichs kandidieren. So könnten Sie beispielsweise die Leistung eines landesweiten Kandidaten mit der Leistung anderer landesweiter Kandidaten im selben Bundesstaat vergleichen.
Dieser Ansatz vermeidet einige der Probleme des Uniform-Swing-Ansatzes. Es ist nicht erforderlich, dass wir unbeholfen aus früheren Wahlergebnissen schließen. Konstruktionsbedingt berücksichtigt es die Demografie und andere Arten von Variationen zwischen verschiedenen Wählergruppen, da es vergleicht, wie verschiedene Kandidaten im selben Jahr bei genau denselben Wählern abgeschnitten haben. Wir müssen uns nicht länger fragen, ob Michigan 2024 mit Michigan 2026 oder Michigan 2026 mit Texas 2026 vergleichbar ist. Stattdessen wird bei diesem Ansatz nur Michigan 2026 mit Michigan 2026 verglichen.
Aber dieser Ansatz mit überlappenden Wahlen hat immer noch einige der gleichen Probleme wie der Uniform-Swing-Ansatz und einige einzigartige eigene Probleme.
Wie der Uniform-Swing-Ansatz geht auch der Ansatz der überlappenden Wahlen faktisch davon aus, dass republikanische Kandidaten niemals schlechtere oder überdurchschnittliche Leistungen erbringen. Aber das ist offensichtlich unwahr. In Texas: Der gewählte Senator Talarico (Dem)erhalten55,1 Prozent der Stimmen, während die gewählte Gouverneurin Gina Hinojosa (Dem) 52,8 Prozent der Stimmen erhielt. Der Ansatz der überlappenden Wahlen würde bedeuten, dass Talarico um 2,3 Punkte besser abgeschnitten hat, oder alternativ, dass Hinojosa um 2,3 Punkte schlechter abgeschnitten hat.
Diese Zahlen lassen jedoch keinen solchen Schluss zu. Eine andere Erklärung wäre schließlich, dass Talarico und Hinojosa genau die gleichen Leistungen erbrachten, während Talaricos Gegner, der von Skandalen geplagte Erstkandidat für den Senat Ken Paxton, um 1,15 Punkte schlechter abschnitt und Hinojosas Gegner, der seit zwölf Jahren amtierende Greg Abbott, um 1,15 Punkte besser abschnitt.
Der Ansatz der überlappenden Wahlen ist ebenfalls nicht in der Lage, dies zu bestimmenAbsoluteQualität der Kandidaten in einer bestimmten Region, nur ihrerelativPositionen zueinander (falls vorhanden). Der Uniform-Swing-Ansatz verwendet vermutlich nationale Durchschnittswerte auf der Grundlage der Theorie, dass eine große Stichprobe in vielen Regionen einen zuverlässigeren Indikator für die durchschnittliche Kandidatenqualität darstellt. Wenn Ihr Datensatz jedoch nur eine Handvoll sich überschneidender Rassen umfasst, ist es durchaus möglich, dass ein unverhältnismäßig großer Anteil der Kandidaten in Ihrem Datensatz (möglicherweise sogar alle Kandidaten in Ihrem Datensatz) leistungsschwache oder überdurchschnittliche Leistungen erbringen. Ein Senator, der knapp über einem Gouverneur oder der Gesamtabstimmung des Repräsentantenhauses liegt, könnte ein Überdurchschnittlicher sein, aber er könnte auch ein Unterdurchschnittlicher sein, umgeben von noch stärker Unterdurchschnittlichen. Dieser Ansatz kann nicht zwischen den beiden unterscheiden.
Ein weiteres einzigartiges Problem des Ansatzes sich überschneidender Wahlen besteht darin, dass davon ausgegangen wird, dass der einzige Grund, warum ein Wähler seine Wählerstimmen aufteilen würde – z. B. für einen Demokraten als Senator und dann einen Republikaner als Gouverneur oder Repräsentantenhaus –, in den unterschiedlichen Eigenschaften der Kandidaten liegt, die in den verschiedenen Rennen antreten.
Aber das ist nicht wahr. Ein Wähler kann seine Wählerstimmen auch aufteilen, weil die Befugnisse der verschiedenen Ämter, über die er abstimmt, unterschiedlich sind. Ein Wähler, der normalerweise die Republikaner unterstützt, aber Donald Trump nicht mag und seine Macht zügeln möchte, unterstützt möglicherweise einen Republikaner für den Gouverneursposten und gleichzeitig einen Demokraten für das Repräsentantenhaus. Derselbe schlanke republikanische Wähler unterstützt zwar einen Demokraten für das Repräsentantenhaus, könnte aber einen Republikaner für den Senat unterstützen, da die Amtszeit der Senatoren sechs Jahre beträgt und alle Repräsentanten des Repräsentantenhauses im Jahr 2028 erneut zur Wiederwahl antreten.
Selbst wenn nur ein kleiner Prozentsatz der Wähler auf diese (ziemlich rationale) Weise denkt, reicht das aus, um die meisten Punktunterschiede, die wir in diesen sich überschneidenden Wahlergebnissen sehen, völlig zu überdecken, insbesondere wenn man die anderen oben identifizierten Probleme hinzufügt.
C. Regressionsmodelle
Einer der am wenigsten verbreiteten Ansätze zur Quantifizierung des erwarteten Stimmenanteils ist gleichzeitig auch der ausgefeilteste: Regressionsmodelle. Anstatt einen einheitlichen Wahlschwung anzunehmen oder sich überschneidende Wahlen zu betrachten, werfen Sie eine Vielzahl von Variablen in ein Modell, das für jede Region einen erwarteten Stimmenanteil ausspuckt. Es wird dann angenommen, dass der Unterschied zwischen den Ergebnissen des Modells und dem tatsächlichen Stimmenanteil auf Kandidateneffekte zurückzuführen ist.
Soweit ich weiß, sind dies die beiden Hauptquellen für diesen AnsatzGeteiltes Ticket, was jetzt bei istDas Argument, UndStärke in Zahlenunter der Leitung von G. Elliot Morris.
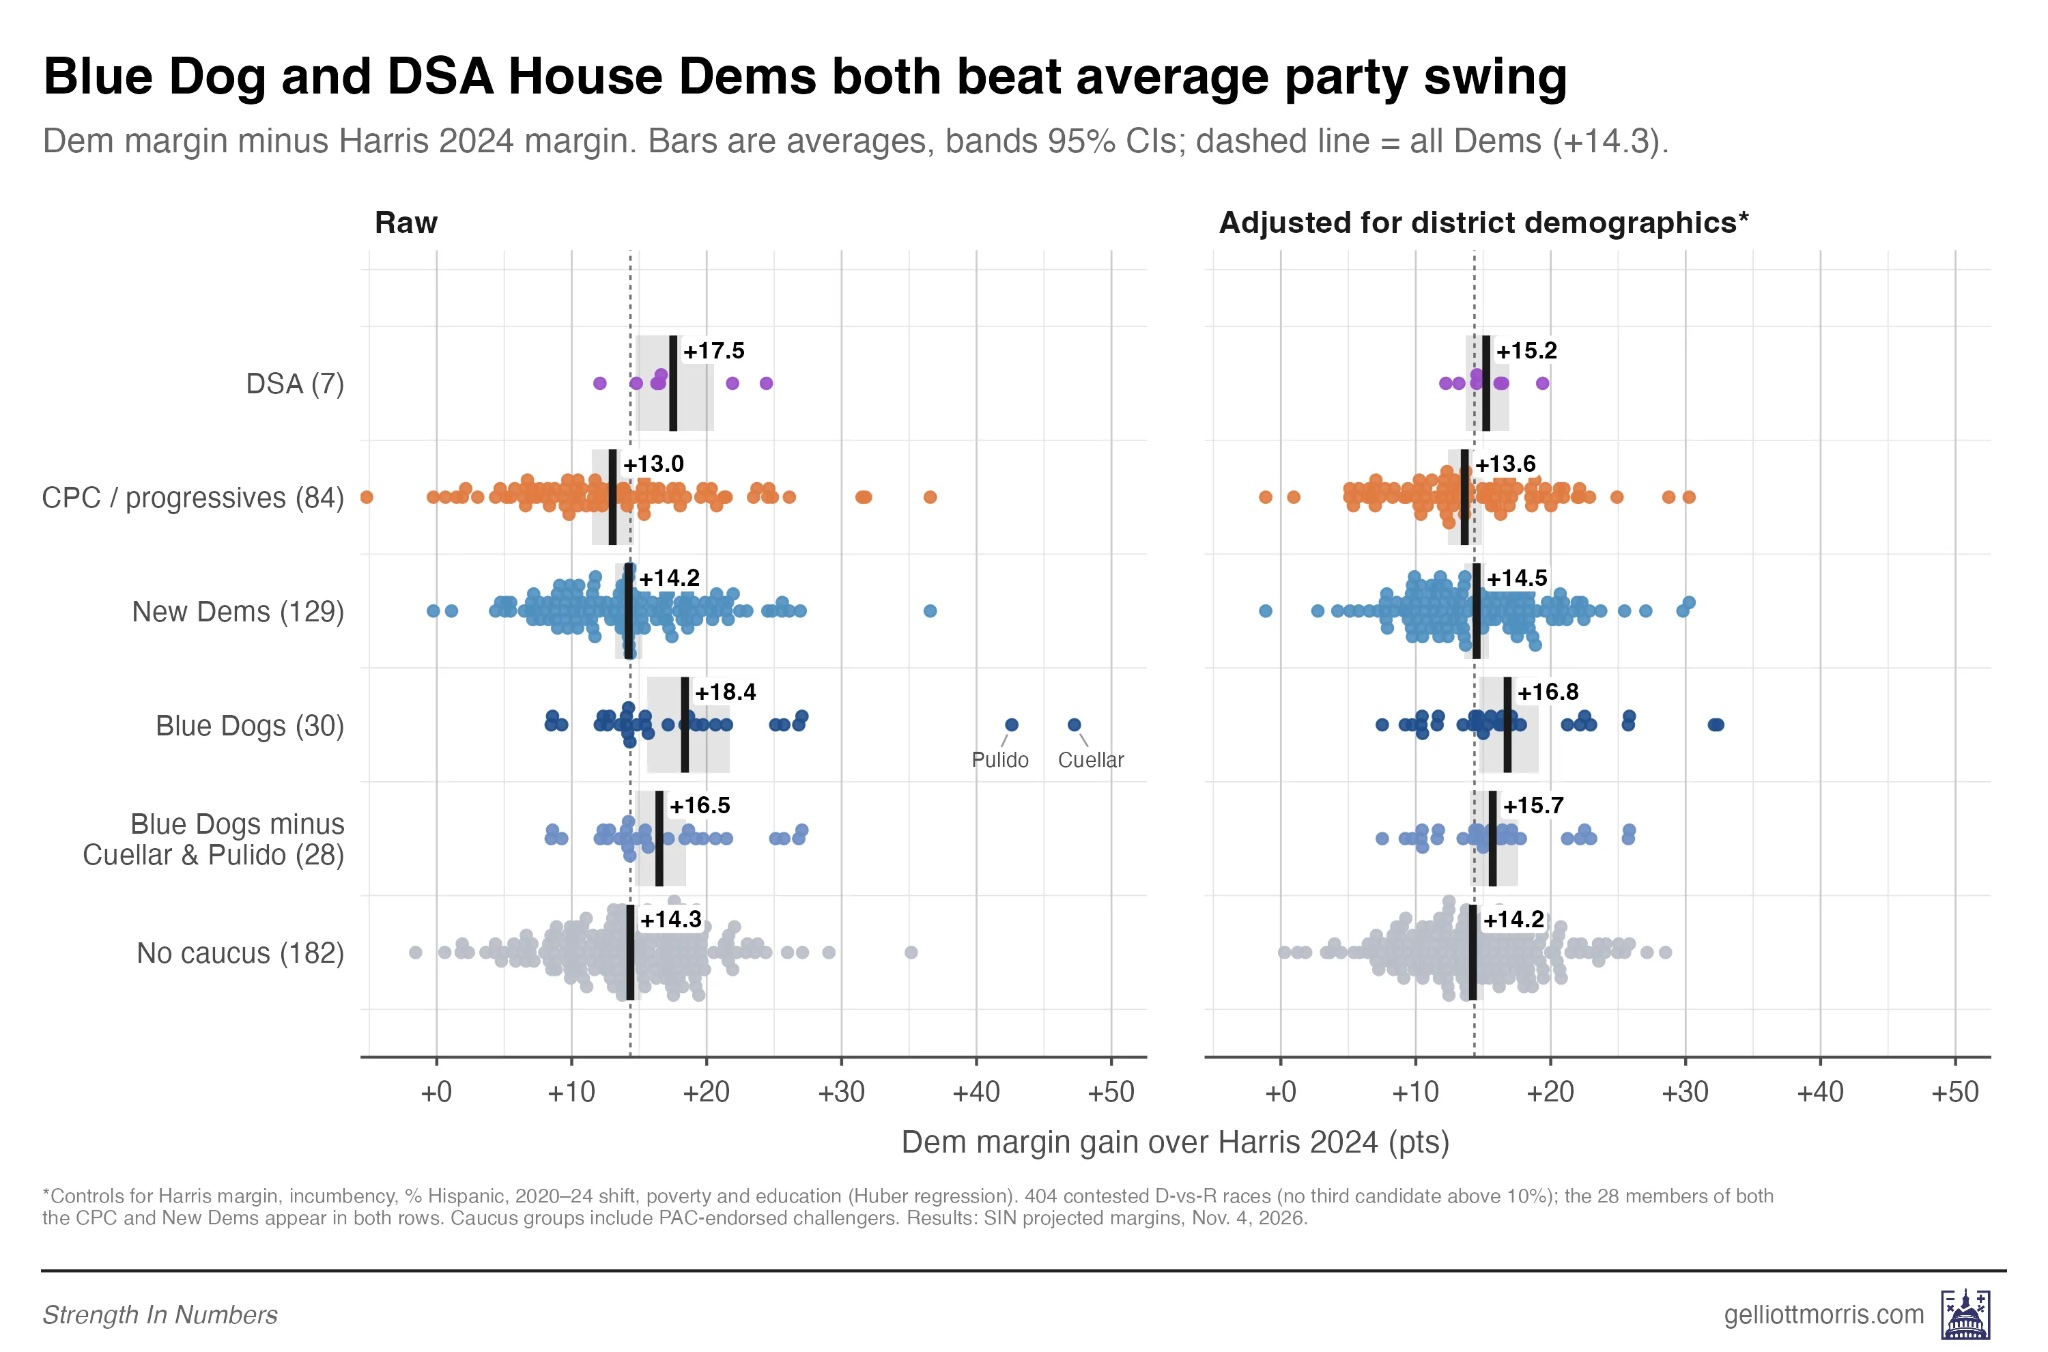
Bei dieser Wahl zeigte der Ansatz „Stärke in Zahlen“ keinen wirklichen Unterschied zwischen den verschiedenen ideologischen Gruppierungen der Kandidaten des Repräsentantenhauses. Wenn überhaupt, schnitten die Kandidaten der Democratic Socialists of America (DSA) besser ab als der durchschnittliche Demokrat.
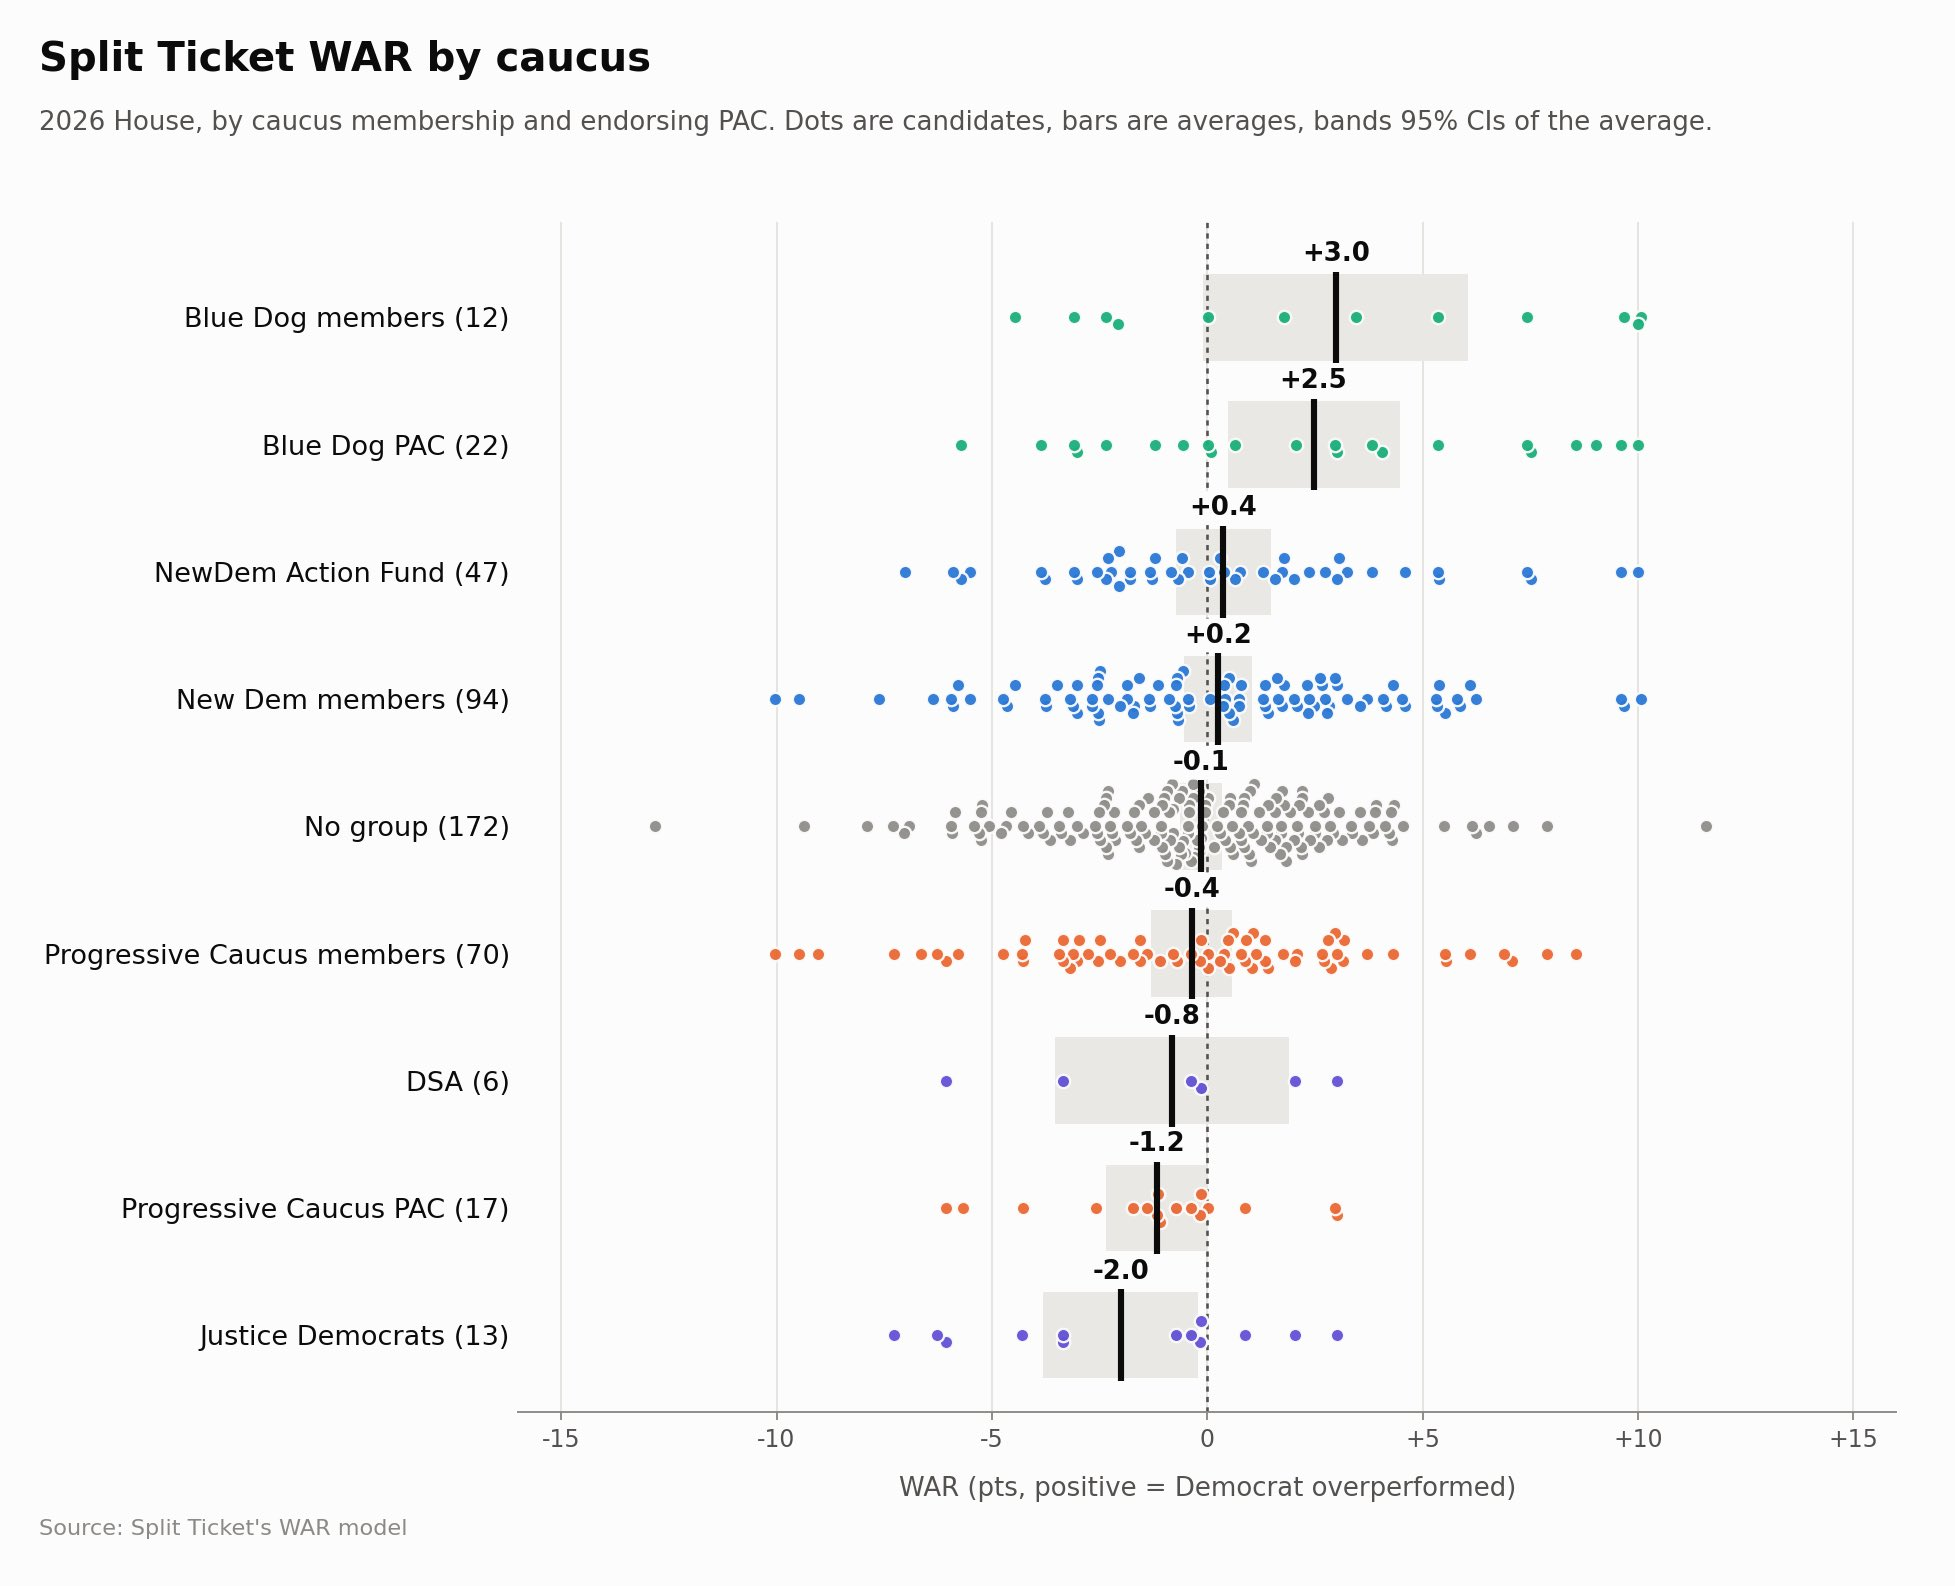
Split Ticket, das ein anderes Regressionsmodell verwendet, erreichte ein ähnliches Ergebnis, wobei nur die Kandidaten der Blue Dogs und Justice Democrats Leistungsergebnisse erzielten, die (geringfügig) von Null unterschieden wurden.
Der Economist veröffentlichte auch dieErgebnisseeines Modells, das es offenbar für die Wahl zusammengestellt hat. Nach diesem Modell und seinen Kandidatengruppierungen übertrafen die Gemäßigten die Erwartungen um weniger als einen Punkt, während die Progressiven um den gleichen Betrag hinter den Erwartungen zurückblieben.
Das Hauptproblem bei diesem Modellierungsansatz besteht lediglich darin, dass nicht völlig klar ist, welche Variablen in die Modelle einbezogen werden sollen. Deshalb unterscheiden sie sich alle voneinander.
Ein weiteres Problem, das allen diesen Ansätzen mit erwarteter Abstimmung zu schaffen macht, besteht darin, dass nicht alle Kandidateneffekte mit der Ideologie zusammenhängen. Kandidaten könnten aufgrund ihrer Identität, z. B. weil sie Muslim sind, besser oder schlechter abschneiden. Sie könnten aufgrund ihrer Persönlichkeit besser oder schlechter abschneiden, z. B. ob sie charismatisch sind oder nicht. Wie wir in den Streudiagrammen oben sehen können, übersteigen die Unterschiede zwischen den Kandidaten in den einzelnen Buckets tatsächlich die durchschnittlichen Unterschiede zwischen den Kandidaten-Buckets bei weitem. Dieses Problem ist besonders relevant, wenn es um die Kandidatenauswahl geht, z. B. bei der Abstimmung in einer Vorwahl der Demokraten, da es darauf hindeutet, dass die nichtideologischen Aspekte der Kandidaten die ideologischen Aspekte völlig überlagern.
Diese Probleme könnten wohl umgangen werden, wenn die verschiedenen Modelle alle zu ähnlichen Schlussfolgerungen über die Qualität der Kandidaten kämen und dies mit zu großen Abweichungen, als dass man sie plausibel leugnen könnte. Wenn es um die Progressiv-gegen-Moderate-Frage geht, kommen diese drei Regressionsmodelle grundsätzlich zu ähnlichen Schlussfolgerungen, was eine Null-Schlussfolgerung ist. Die Abweichungen vom Nullwert, die wir in einigen Modellen einiger Kandidatengruppierungen sehen, sind so gering, dass sie durch jegliche Salzstreuung völlig ausgelöscht werden können.
III. Wohin uns das führt
Offensichtlich ist den meisten Diskursteilnehmern das alles egal und sie bewegen sich gerne in den Diagrammen um, die ihnen zeigen, dass die Wissenschaft beweist, dass ihre Politik die beste ist. Aber unter pro-gemäßigten Experten, denen es zumindest einigermaßen wichtig ist, ein vertretbares Argument in der Sache aufrechtzuerhalten, habe ich in letzter Zeit eine Art Vorschlag gesehen, in dem pro-progressive Experten übereinstimmen, dass die Gemäßigten besser abschneiden als die Progressiven, im Gegenzug dafür, dass pro-gemäßigte Experten zustimmen, dass der Abstand sehr gering ist. BeideJonathan ChaitUndMatt Yglesiassind nach der Wahl diesen Weg gegangen. In jüngeren Gesprächen, die ich mit Yglesias geführt habe, scheint er sich etwas weiter zurückzuziehen und anzuerkennen, dass der moderate Vorteil in den Daten nicht zuverlässig nachgewiesen werden kann, sondern auf starken theoretischen Grundlagen beruht.
Das Problem bei diesen strategischen Rückzügen besteht darin, dass der Unterschied zwischen Null und nahezu Null nicht groß genug sein wird, um jemanden davon zu überzeugen, politische Initiativen aufzugeben, die er für wichtig hält, insbesondere angesichts der Tatsache, dass sich die Popularität politischer Maßnahmen im Laufe der Zeit teilweise aufgrund der Befürwortung politischer Befürworter ändert. Wenn die aktuelle Wahlstrafe für die Befürwortung einer einheitlichen Gesundheitsversorgung anstelle einer Ausweitung der Obamacare-Subventionen 1 Punkt oder weniger beträgt, wäre es verrückt, wenn jemand, der glaubt, eine einheitliche Gesundheitsversorgung würde die Gesellschaft dramatisch verbessern, darauf verzichten würde, insbesondere wenn die Alternative besteht, einige Wähler davon zu überzeugen, ihre Meinung in dieser Hinsicht zu ändern, wozu auch die Aufstellung von Kandidaten gehört, die dafür plädieren.
Dieser Artikel erschien ursprünglich inJakobiner, ein demokratisch-sozialistisches Magazin, das ausführliche Essays und Analysen zu Politik, Wirtschaft und Kultur veröffentlicht.Abonnieren Sie die Printausgabe für 20 $ pro Jahr.